Зачем компьютеру понадобился третий вычислительный блок
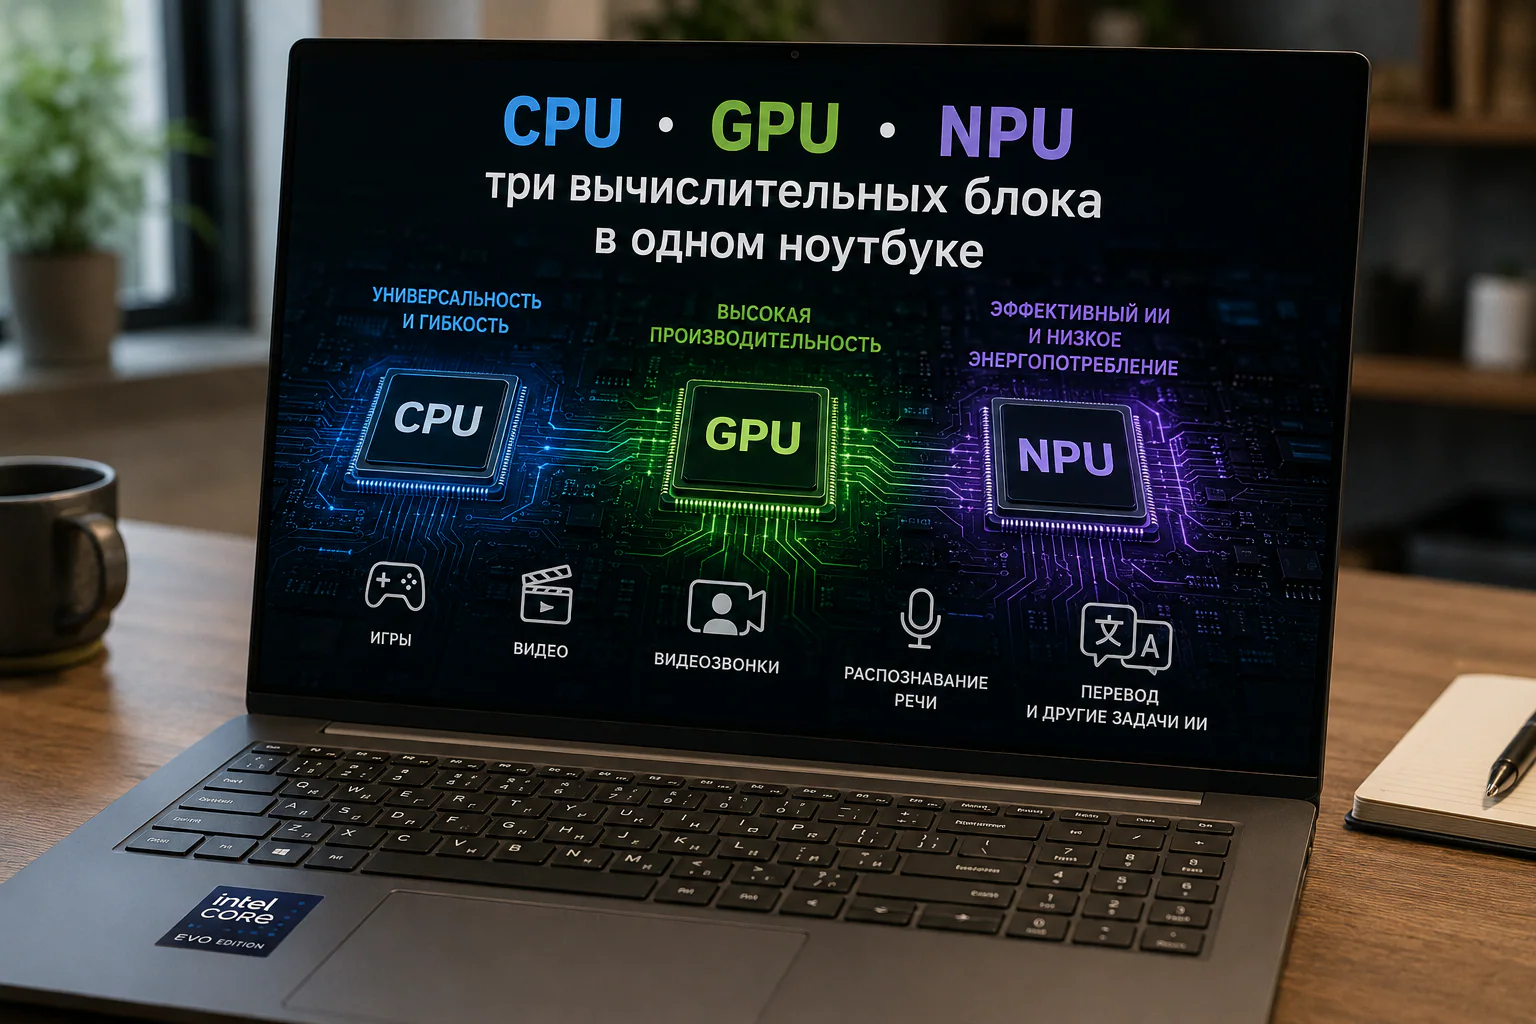
Процессор общего назначения умеет выполнять практически любой программный код. Его сильная сторона заключается в универсальности, быстром выполнении последовательных задач, ветвлений и операций, которые трудно заранее свести к однотипным вычислениям.
GPU устроен иначе. Видеокарта содержит большое количество параллельных вычислительных блоков и хорошо подходит для операций, где одни и те же действия выполняются одновременно над большим массивом данных. Именно поэтому GPU оказался удобен не только для графики, но и для обучения и запуска нейросетей.
Модели машинного обучения добавили еще один характерный тип нагрузки. Большая часть вычислений при инференсе, то есть при использовании уже обученной нейросети, сводится к огромному числу матричных операций. Высокая точность вычислений, необходимая для части традиционных программ, при этом часто не требуется. Модель можно перевести на INT8, INT4 или другой компактный формат и получить выигрыш по скорости, памяти и энергопотреблению.
Для таких задач появился NPU, Neural Processing Unit. Это специализированный аппаратный блок, рассчитанный на выполнение операций нейронных сетей с высокой эффективностью.
В мобильном компьютере у него есть дополнительная задача. Если постоянный эффект шумоподавления во время видеозвонка можно выполнять на небольшом NPU, нет необходимости держать активной более мощную графическую часть процессора. Снижается нагрузка на CPU и GPU, а для ноутбука это напрямую связано с расходом энергии.
Intel поэтому описывает собственное распределение задач довольно четко: CPU предназначен в том числе для AI-нагрузок с малой задержкой, GPU для высокой вычислительной производительности, NPU для продолжительных AI-задач с низким энергопотреблением. Это архитектурная логика производителя, а не правило, которому обязана следовать каждая программа.
NPU не является маленькой видеокартой
У NPU и GPU есть пересечение по типу вычислений. Оба могут быстро выполнять матричные операции, оба используются для машинного обучения, оба способны работать с пониженной точностью.
Разница находится в масштабе, универсальности и энергетическом бюджете.
Современный дискретный GPU содержит гораздо больше вычислительных ресурсов, собственную высокоскоростную память и инфраструктуру, рассчитанную на тяжелые параллельные задачи. Он может рендерить игры, кодировать видео, выполнять вычисления CUDA, DirectML, OpenCL и запускать крупные нейросетевые модели.
NPU обычно является значительно меньшим блоком внутри мобильной SoC. Его задача не состоит в замене RTX, Radeon или даже встроенной графики для всех задач ИИ. Он должен эффективно исполнять поддерживаемые нейросетевые графы и при этом занимать небольшую площадь кристалла и расходовать сравнительно мало энергии.
Это объясняет ситуацию, которая сначала кажется странной. В одном процессоре GPU может иметь больше AI-TOPS, чем NPU, но Microsoft все равно проверяет для Copilot+ именно производительность NPU.
У Intel Core Ultra 200V, например, производитель заявляет для платформы до 120 INT8 TOPS суммарно. Из них до 48 TOPS приходится на NPU, до 67 TOPS на GPU и до 5 TOPS на CPU. Складывать эти числа и считать результат эквивалентом одного 120-TOPS ускорителя нельзя. Это три разных вычислительных блока с разными интерфейсами, ограничениями и назначением.
Что означает TOPS
TOPS расшифровывается как Tera Operations Per Second, триллионы операций в секунду.
Производитель берет количество вычислительных блоков, число операций, которое они способны выполнить за такт, и рабочую частоту. На этой основе получается теоретическая пиковая производительность.
Intel прямо определяет TOPS как теоретический максимум при полной загрузке AI-ускорителя. Для своих актуальных показателей компания обычно использует INT8 без учета sparsity, если отдельно не указано обратное. Объяснение TOPS у Intel полезно именно этим уточнением: одна цифра имеет смысл только вместе с типом операции и условиями расчета.
Если NPU способен теоретически выполнять 50 триллионов INT8-операций в секунду, это не означает, что любая нейросеть на нем будет обрабатывать данные со скоростью 50 триллионов полезных операций.
Часть времени тратится на передачу данных. Модель может содержать операции, которые конкретный ускоритель не поддерживает. Не все вычислительные блоки удается занять одновременно. Размеры входных данных, структура модели, работа компилятора и память также влияют на результат.
TOPS поэтому ближе к пиковой паспортной вычислительной способности, чем к результату готовой программы.
Сравнивать по нему устройства можно только при сопоставимых методиках.
Почему 50 TOPS одного NPU не обязательно быстрее 45 TOPS другого
Предположим, один ноутбук имеет NPU на 50 TOPS, второй на 45 TOPS. Разница по паспортной цифре составляет около 11%.
Это еще не позволяет предсказать разницу в приложении.
Первый NPU может лучше выполнять сверточную сеть для обработки изображения, а второй эффективнее запускать Transformer. Один компилятор способен разместить модель практически целиком на ускорителе, другой вынужден возвращать часть операций на CPU.
Переход между устройствами сам по себе имеет стоимость. Если нейросетевой граф постоянно прыгает с NPU на процессор и обратно, задержки копирования и синхронизации съедают часть выигрыша.
В документации Ryzen AI это видно буквально на уровне выполнения модели. AMD указывает, что поддерживается определенный набор операторов ONNX. Граф автоматически разбивается на части: совместимые операции отправляются на NPU, остальные могут выполняться на CPU. Документация Ryzen AI также описывает квантование моделей и работу через ONNX Runtime.
Поэтому правильный тест NPU должен запускать одну и ту же модель, с одинаковой точностью, размерами входа и программным стеком.
Сравнение цифр на коробке этого не делает.
Почему производители говорят про INT8
Нейросети традиционно обучаются с использованием чисел с плавающей точкой. FP32 дает большой диапазон и точность, но требует много памяти и вычислений.
При инференсе точность часто можно уменьшить.
Вместо 32-битного числа вес модели хранится, например, как 8-битное целое. Такая процедура называется квантованием. Модель занимает меньше памяти, уменьшается объем передаваемых данных, ускоряются матричные операции.
Для некоторых сетей снижение точности почти не влияет на качество результата. Для других требуется более аккуратная калибровка или смешанная точность.
Поэтому NPU проектируются вокруг низкоточных форматов. INT8 стал удобной точкой сравнения, но современные ускорители поддерживают и другие варианты.
Это создает еще одну проблему с TOPS. Показатель при INT4 может оказаться намного выше, чем при INT8, потому что за то же время аппаратный блок обрабатывает больше коротких значений. Сравнивать INT4 TOPS одного устройства с INT8 TOPS второго нельзя.
То же касается sparsity. Если производитель считает, что часть весов модели равна нулю и соответствующие операции можно пропустить, формальный показатель способен вырасти. Поэтому у корректной цифры AI-производительности всегда должна быть сноска о типе данных и методике.
40 TOPS Microsoft не являются магической границей скорости
После появления Copilot+ PC число 40 стало восприниматься как техническая граница между обычным компьютером и AI PC.
На самом деле это квалификационное требование конкретной платформы Microsoft.
В руководстве для разработчиков Microsoft указывает, что для ряда функций Copilot+ требуется NPU производительностью 40 и более TOPS. В этот класс вошли системы Snapdragon X, AMD Ryzen AI 300 и Intel Core Ultra 200V. Актуальное руководство Microsoft для Copilot+ PC описывает NPU как отдельное требование для соответствующих возможностей Windows.
Компьютер с NPU на 38 TOPS не становится в два раза медленнее системы на 40 TOPS.
И ноутбук без 40-TOPS NPU не перестает запускать нейросети. Его CPU или GPU могут быть очень быстрыми. Дискретная видеокарта среднего и высокого класса способна значительно обгонять мобильный NPU в тяжелых задачах машинного обучения.
Граница нужна Microsoft для гарантированного набора возможностей и характеристик платформы.
Для покупателя 40 TOPS следует читать как условие совместимости с определенным классом Windows-функций, а не как универсальный рейтинг производительности ИИ.
Зачем Windows вообще знает о NPU
Если каждое приложение должно отдельно поддерживать Qualcomm Hexagon, AMD XDNA и Intel AI Boost, разработка локального ИИ быстро превращается в набор разных аппаратных версий.
Windows пытается создать над этим промежуточный слой.
В 2026 году Microsoft продвигает Windows ML как основной способ запуска моделей через доступные ускорители. Среда может работать с CPU, GPU и NPU и использует execution provider, то есть аппаратно-зависимый исполнитель для конкретной платформы. Для поддерживаемого оборудования нужный провайдер может загружаться автоматически.
В июльской документации 2026 года Microsoft прямо указывает переход от DirectML к Windows ML как рекомендуемому способу доступа к NPU и GPU в новых приложениях. Windows ML и поддерживаемые ускорители показывают, насколько программный стек стал частью реальной производительности NPU.
Аппаратный блок без драйвера и подходящего runtime почти бесполезен.
Это хорошо знакомо по видеокартам. Один и тот же GPU может показывать разную скорость в зависимости от API, драйвера и оптимизации программы. Для NPU зависимость еще сильнее, поскольку экосистема значительно моложе.
Почему программа может иметь доступ к NPU, но продолжать использовать GPU
Разработчик выбирает устройство не по принципу «NPU новее».
Сначала оценивается модель.
Если она слишком большая для эффективного выполнения на NPU, выгоднее использовать GPU. Если в ней много неподдерживаемых операторов, постоянное переключение на CPU способно сделать NPU бессмысленным. Если задача запускается один раз и должна закончиться максимально быстро, энергопотребление может быть менее важным, чем пиковая скорость.
Есть и противоположный случай.
Нейросеть шумоподавления должна работать все время, пока открыт видеозвонок. Ее вычислительная нагрузка относительно небольшая, но длится часами. Здесь экономичный NPU подходит значительно лучше.
Microsoft использует этот подход в Windows Studio Effects. Модели для автоматического кадрирования, коррекции взгляда, размытия фона и обработки голоса могут выполняться на NPU, уменьшая нагрузку на основные вычислительные блоки. Компания описывает именно энергоэффективное исполнение как одну из причин аппаратного ускорения этих эффектов.
Это и есть типичная задача NPU: не показать максимальный результат в коротком бенчмарке, а незаметно выполнять нейросеть в фоне.
Почему локальная большая языковая модель остается сложной задачей для NPU
LLM требует гораздо больше, чем способность быстро перемножать матрицы.
В память нужно поместить веса модели. Во время генерации растет KV-cache. Скорость чтения данных из памяти начинает влиять на число токенов в секунду. Для длинного контекста требования дополнительно увеличиваются.
Возьмем модель с 8 миллиардами параметров. При хранении каждого параметра в FP16 только веса занимают примерно 16 ГБ. В INT8 получится около 8 ГБ, в 4-битном виде около 4 ГБ до учета служебных данных.
У ноутбучного NPU обычно нет отдельной видеопамяти. Он работает с общей системной RAM.
Поэтому компьютер с 16 ГБ памяти и мощным NPU может быть менее удобен для локальных LLM, чем система с более слабой паспортной NPU-производительностью, но 32 или 64 ГБ RAM и хорошей пропускной способностью памяти.
Оперативная память становится частью AI-платформы.
Именно поэтому современные мобильные SoC с NPU одновременно получают быструю LPDDR5X и широкую шину памяти. TOPS без этого показателя описывают только вычислительную часть задачи.