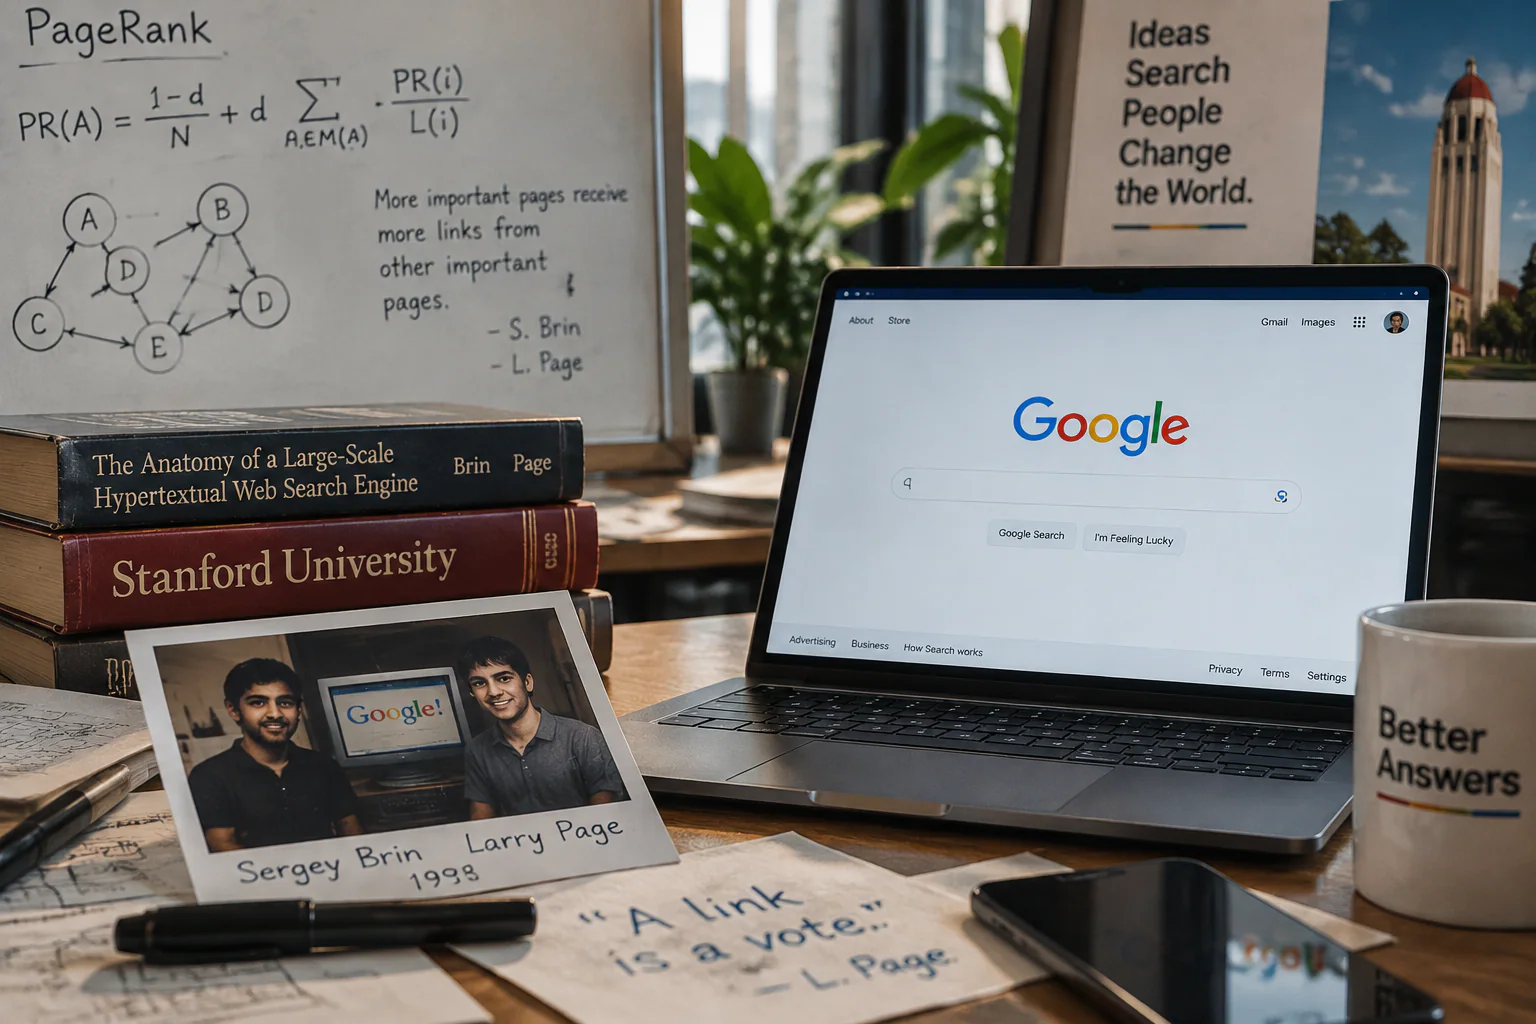
До Google интернет уже умел искать, но плохо понимал важность информации
В середине 1990-х интернет рос быстрее, чем развивались способы навигации по нему. Существовали каталоги сайтов и поисковые системы, которые в основном ориентировались на совпадение слов в документах. Проблема была не в отсутствии информации, а в ее количестве.
Если пользователь вводил запрос, поисковик мог найти тысячи страниц с нужными словами, но не всегда понимал, какая из них действительно полезна. Владельцы сайтов быстро научились использовать особенности таких систем: добавлять популярные ключевые слова, создавать страницы с большим количеством повторов и другими способами пытаться подняться выше в выдаче.
В своей работе «The Anatomy of a Large-Scale Hypertextual Web Search Engine» Сергей Брин и Ларри Пейдж описали именно эту проблему. Они отмечали, что обычный поиск по ключевым словам плохо справлялся с огромным количеством страниц и требовался способ использовать дополнительную структуру самого интернета. В качестве такой структуры они предложили анализ ссылок между страницами.
PageRank превратил ссылки в систему рекомендаций
До появления PageRank ссылка воспринималась в основном как технический элемент навигации. Страница ссылалась на другую страницу, чтобы пользователь мог перейти дальше. Брин и Пейдж предложили рассматривать ссылки как своеобразные голоса доверия.
Но важен был не сам факт ссылки. Ссылка с неизвестного сайта и ссылка с ресурса, который сам имеет высокий авторитет, не должны иметь одинаковый вес.
Именно это стало основой PageRank. Алгоритм оценивал важность страницы через структуру ссылок всего интернета. Если на страницу ссылались другие значимые ресурсы, ее рейтинг повышался. Если важная страница ссылалась на другой сайт, она передавала часть своего веса.
В оригинальной работе Google PageRank описывался как объективная оценка значимости страницы на основе графа ссылок. Авторы сравнивали эту идею с научными публикациями, где количество и качество цитирований помогают оценивать влияние работы.